« Les LLM ne sont que des prédicteurs du mot (token) suivant. »
Techniquement vrai. Mais je pense que cela ne raconte que la moitié de l’histoire.
Je préfère un autre nom : des machines à probabilités conditionnelles.
Cela sonne plus technique, je sais. Mais un mot change la façon d’utiliser ces outils : conditionnelles.
Quand un modèle écrit son prochain mot, il ne se demande pas « quel mot vient habituellement ensuite ? » Il se demande « quel mot vient ensuite, sachant tout ce que j’ai vu jusqu’ici ? »
En mathématiques, on l’écrit ainsi :
P(mot suivant | tout ce qui précède)
Cette petite barre verticale signifie « sachant que ». Et c’est elle qui fait tout le travail.
« Tout ce qui précède », c’est bien plus que votre dernière question :
- les instructions que vous avez saisies
- les instructions système cachées de l’application
- les fichiers et documents que vous avez importés
- tout l’historique de la conversation
- les résultats de recherche et les sorties d’outils
- les mots que le modèle a déjà écrits dans sa propre réponse
Essayez : la même demande, des conditions différentes
Ci-dessous, la demande est toujours « Suggérez un nom. » Vous ne pouvez pas la modifier. Ce que vous pouvez faire, c’est ajouter des lignes plus tôt dans la conversation, et regarder bouger les probabilités du modèle.
Interactif · démo illustrative
Même demande. Changez la condition.
1 · Construisez la condition
Touchez une ligne pour la placer plus tôt dans la conversation. Touchez-la encore pour la retirer. La dernière ligne est fixe.
- Vous, maintenantSuggérez un nom.Verrouillée. La demande ne change jamais.
- Mots de la demande modifiés
- 0
- Lignes de contexte ajoutées
- 1
2 · Ce que le modèle risque de répondre
S’il répond par un nom, quelle est la probabilité de chacun ?
- Max34 %
- Bella27 %
- Sunny15 %
- Alex3 %
- Nova2 %
- Sentinelle< 1 %
- Bastion< 1 %
- Cipher< 1 %
- Autres noms18 %
Avec votre conditionSans contexte
Le plus probable : Max, 34 %. Sans contexte, Max avait 12 %.
Chaque essai est un tirage au hasard dans les barres ci-dessus. Même demande, même modèle, réponses différentes.
Une démo illustrative, pas un vrai modèle. Les probabilités sont écrites à la main pour montrer le mécanisme. Un vrai modèle les répartit sur des dizaines de milliers de mots possibles et lit des conditions bien plus longues.
Trois choses à essayer :
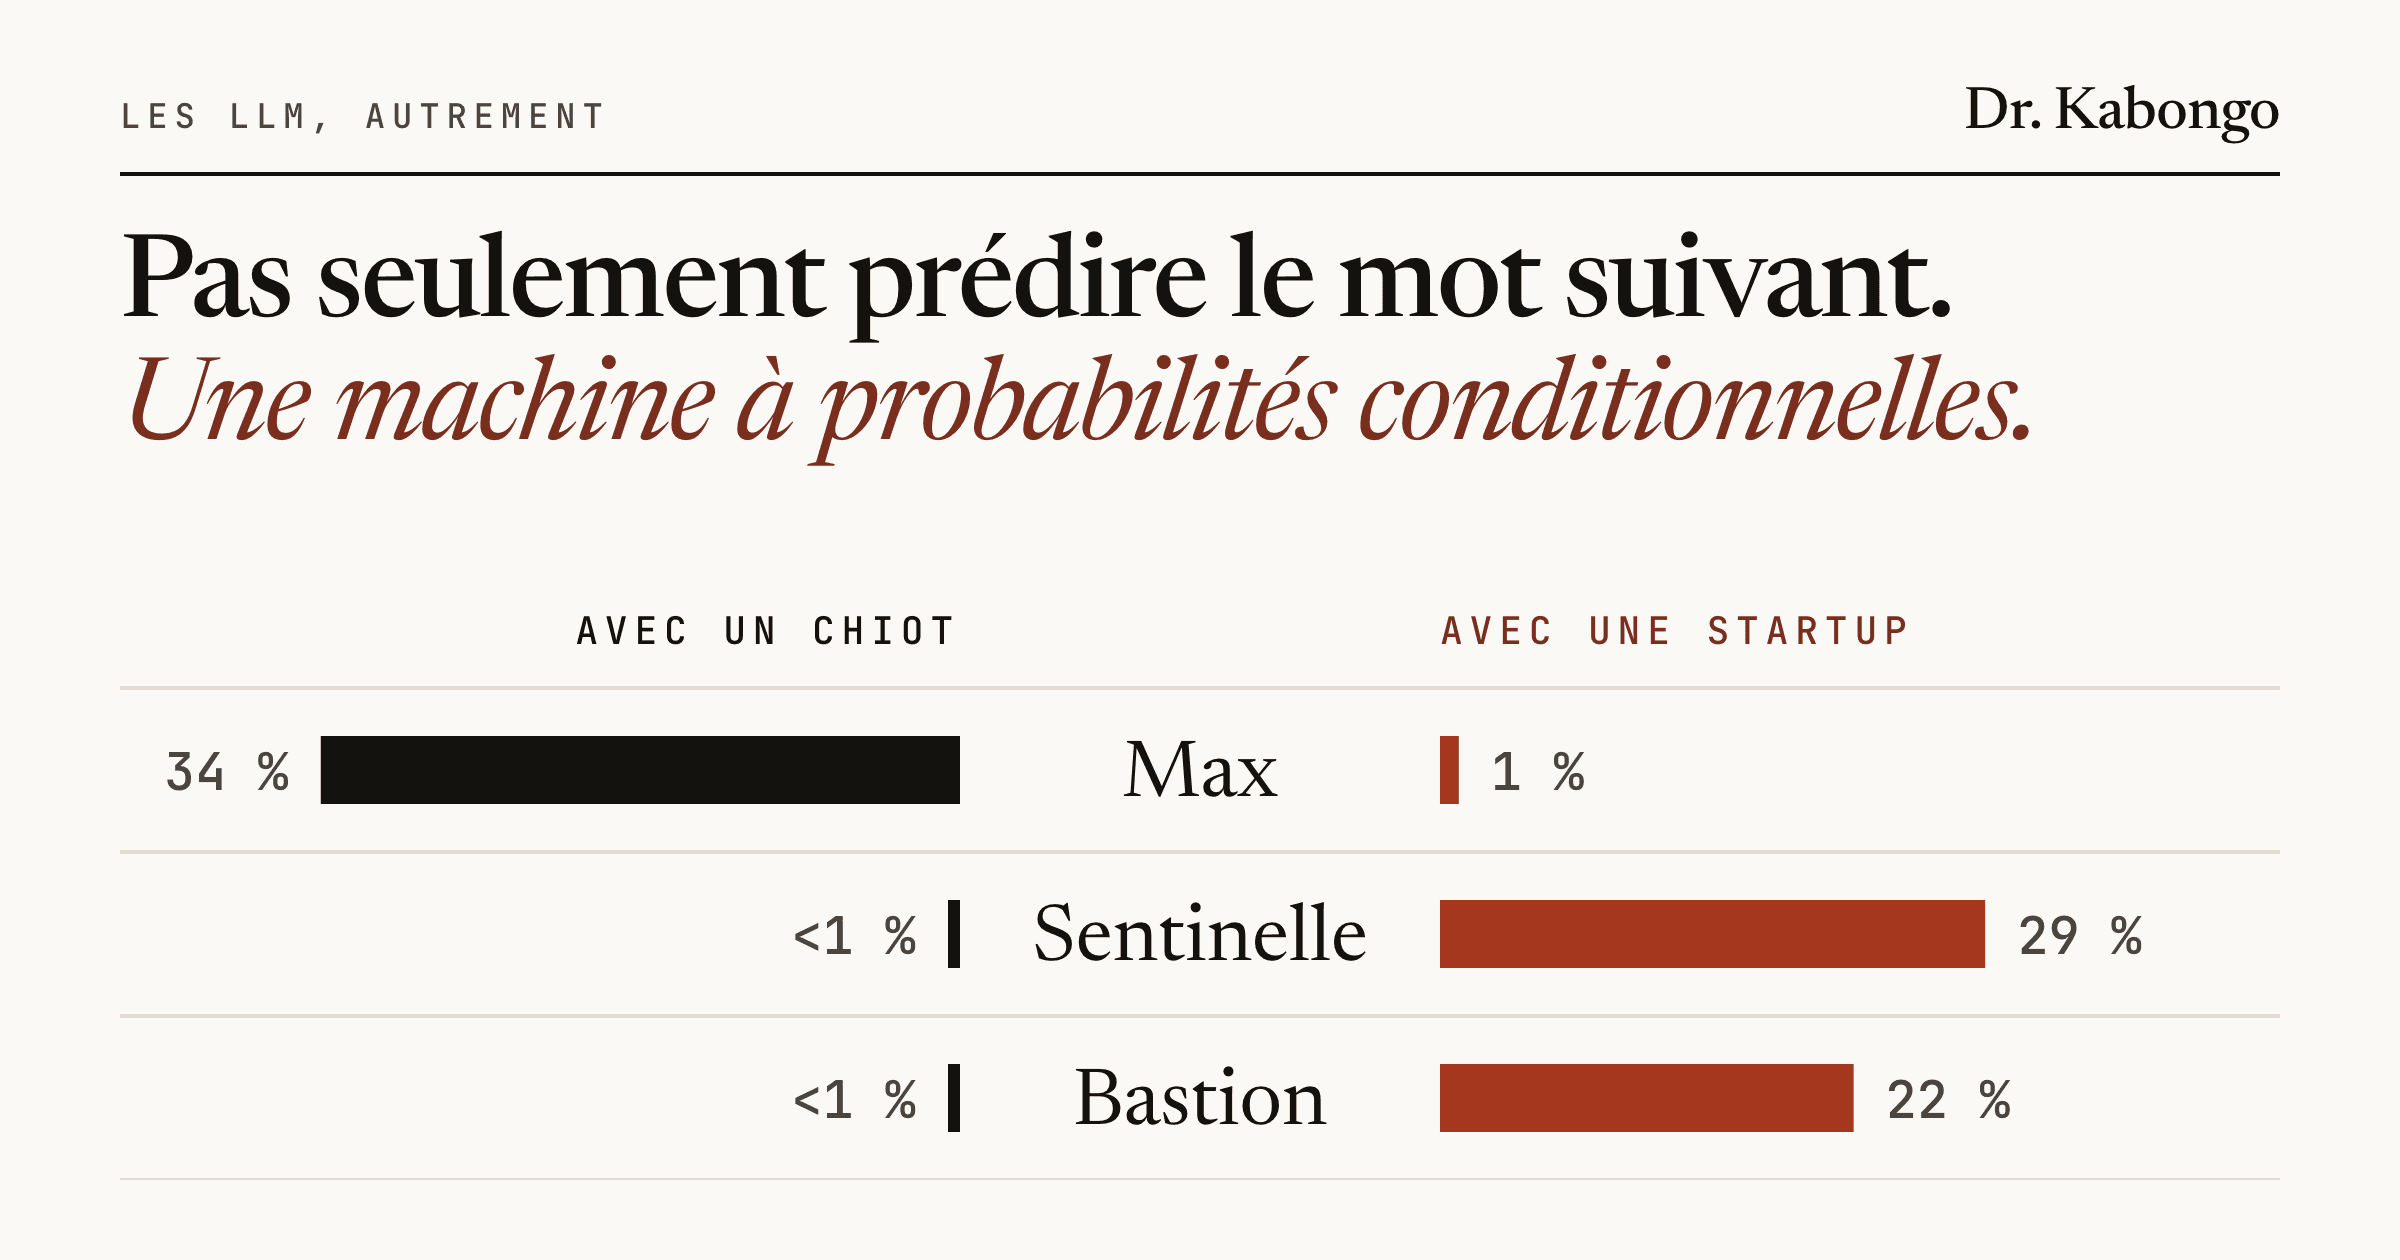
- Ajoutez la ligne du chiot. « Max » et « Bella » prennent la tête. Remplacez-la par la startup de cybersécurité : « Max » tombe à 1 %, et « Sentinelle » et « Bastion » prennent le relais.
- Retirez tout. Sans rien d’autre, aucun nom ne dépasse 12 %. Le modèle retombe sur les réponses les plus moyennes.
- Ajoutez le chiot et la startup ensemble. La condition tire dans deux directions, donc la réponse devient floue. Ajoutez le consultant en marque à la startup, et elle se précise.
La demande n’a pas changé. Le modèle n’a pas changé. La condition, si.
C’est vrai pour tous les LLM : Gemini, GPT, Claude, Llama, tous. Le modèle décide comment il réagit au contexte. Vous décidez de ce qu’est le contexte.
Ce que « sachant que » veut vraiment dire
La barre verticale de P(A | B) est la partie qui glisse entre les doigts. Voici l’intuition : conditionner, c’est réduire le monde, puis recompter.
- Partez de toutes les conversations imaginables.
- Écartez celles où la condition (B) n’est pas vraie.
- Dans ce qui reste, comptez combien de fois l’événement (A) se produit.
C’est tout. Le dénominateur rétrécit, donc la probabilité change. Essayez sur 200 conversations imaginées :
Interactif · démo illustrative
Réduisez le monde, puis recomptez.
Imaginez 200 conversations, chacune terminée par une réponse à « Suggérez un nom. » Choisissez une question, puis ajoutez une condition et regardez le monde rétrécir.
La probabilité que…
…sachant que…
L’événement se produitLa condition tient, l’événement nonÉcarté par la condition
Comptez ce qui reste
34 %P(Max | chiot) = 17 ÷ 50
Dans 50 conversations, le contexte mentionne un chiot. Dans 17 d’entre elles, la réponse est « Max ».
nombre(les deux) ÷ nombre(condition)
Inversez
71 %P(chiot | Max) = 17 ÷ 24
Les mêmes deux événements, une autre question, une autre réponse.
Un ensemble imaginaire de 200 conversations, construit pour coller aux chiffres de la première démo. C’est une image de l’idée, pas des données d’un vrai modèle.
Deux choses à remarquer :
- « Max » a 12 % de chances en général, 34 % avec un chiot, et 1 % avec une startup. Le même événement, trois mondes différents, trois réponses différentes.
P(A | B)n’est pasP(B | A). Avec un chiot dans le contexte, la réponse est « Max » dans 34 % des cas. Mais quand la réponse est « Max », il y a un chiot dans le contexte dans 71 % des cas. La démo montre les deux nombres, et « Échanger les deux » fait de la question inversée la question principale. Confondre les deux est l’une des erreurs les plus courantes en probabilités.
Un LLM fait cela à chaque mot. Il a appris quels mots suivent d’ordinaire des contextes comme le vôtre. Votre contexte décide dans quelle partie du monde il compte.
Trois choses que cela explique
Les requêtes vagues donnent des réponses génériques. Donnez peu de matière au modèle, et la distribution reste large : ce sont les barres plates de « Aucun contexte » ci-dessus. La suite la plus probable de presque rien, c’est le texte le plus moyen.
Les longues conversations dérivent. Tout ce qui est dans la conversation continue de compter : le plan périmé, l’idée abandonnée, l’hypothèse jamais confirmée. Ces informations restent dans la condition et continuent de tirer chaque prédiction.
Une erreur au début fait boule de neige. Les mots du modèle deviennent eux-mêmes une partie de la condition de tout ce qui suit. Une mauvaise hypothèse à l’étape deux est désormais « donnée » aux étapes trois, quatre et cinq, et chaque étape s’appuie dessus comme si elle était vraie.
« Vous avez raison, je suis passé à côté. »
Beaucoup d’entre nous ont vécu ce moment avec un agent de code.
Le code est écrit. Tous les tests unitaires passent. Le déploiement ne signale aucune erreur. Puis quelque chose casse en production, et c’est une vraie interruption de service. Vous collez les logs dans la conversation, et l’agent répond :
« Vous avez raison, je suis passé à côté. Voici le correctif. »
Et le correctif fonctionne. Alors pourquoi ne l’a-t-il pas trouvé du premier coup ?
Avec cette lentille, la réponse est simple : il n’est pas passé à côté. Il ne l’a jamais eu.
Quand le code a été écrit, les logs de production ne faisaient pas partie de la condition. Ce qui y était : votre demande, le code, et une série de tests au vert. Sachant tout cela, « c’est fait, tout est bon » était la chose la plus probable à dire. Puis vous avez collé le log. La condition a changé, donc la sortie a changé.
« Je suis passé à côté » n’est pas le souvenir d’un échec. Il n’y a pas eu de moment antérieur où le modèle a vu le problème et détourné les yeux. C’est simplement une phrase très probable quand un utilisateur colle une erreur sous un message qui disait « terminé ». Le modèle ne savait pas, jusqu’à ce qu’on le lui dise enfin.
Et dans une nouvelle conversation, il ne se souviendra pas non plus qu’on le lui a dit, sauf si quelque chose remet la leçon dans la condition.
Harnais et compétences construisent la condition pour vous
Si la condition est tout, alors le vrai travail avec l’IA consiste à la construire, et à la construire de façon fiable, pas de mémoire à 18 h un vendredi.
C’est à cela que sert le logiciel autour du modèle. Un harnais (harness), l’outil d’agent qui enveloppe le modèle, décide de ce qui entre dans le contexte avant que le modèle dise un mot : les instructions système, les fichiers lus, les outils appelables, ce que renvoient l’exécuteur de tests et les logs, et le fichier d’instructions du projet.
Les compétences (skills) sont des conditions empaquetées. Une compétence est un ensemble réutilisable d’instructions (et parfois de scripts) que le harnais charge quand une tâche l’exige. Par exemple, une compétence de déploiement qui dit : après le déploiement, lire les logs pendant dix minutes, vérifier le taux d’erreur, et faire un retour avant de déclarer que c’est terminé.
Appliquons cela à l’histoire de l’interruption :
- Donnez à l’agent un outil qui lit les logs et les métriques de production, pour qu’ils puissent faire partie de la condition.
- Mettez la vérification après déploiement dans une compétence ou un hook, pour que chaque déploiement la porte.
- Écrivez la leçon de l’incident dans le fichier d’instructions du projet, pour que la prochaine session démarre avec elle.
Rien de tout cela ne rend le modèle plus intelligent. Cela rend la condition meilleure, à chaque exécution.
Pourquoi les ingénieurs restent dans la boucle
Un modèle ne peut se conditionner que sur ce qu’on lui donne. Et il ne peut pas remarquer ce qui manque, car vu de l’intérieur, une information absente ne ressemble à rien.
Les ingénieurs sont ceux qui savent ce qui n’est pas dans la fenêtre : comment la production se comporte vraiment, ce qui a été promis au client, ce que « terminé » veut dire ici, et ce que coûte une interruption. C’est pourquoi nous restons dans la boucle :
- Nous décidons quelles conditions comptent, et nous remarquons quand l’une d’elles manque.
- Nous vérifions face au monde réel (logs, métriques, utilisateurs), pas seulement face aux tests au vert que le modèle pouvait voir.
- Nous assumons les conséquences. Le modèle produit la suite la plus probable. La responsabilité, elle, ne peut pas être probable.
Il ne s’agit pas de dire que l’IA a besoin d’être surveillée. Il s’agit de rappeler que quelqu’un doit concevoir les conditions, et les confronter à la réalité.
Ce que je fais en pratique
- Donner le contexte dont un collègue avisé aurait besoin : pour qui, l’objectif, les contraintes
- Coller le texte source au lieu d’espérer que le modèle « le connaît »
- Donner aux agents les mêmes signaux que je regarderais moi-même : logs, métriques, sorties de tests
- Transformer les leçons en conditions réutilisables : fichiers d’instructions, compétences, hooks
- Quand une conversation devient confuse, repartir de zéro avec un résumé propre
Ne vous contentez pas de poser une meilleure question. Construisez une meilleure condition.
« La prédiction du mot (token) suivant » décrit ce que fait le modèle.
« La probabilité conditionnelle » décrit ce que vous contrôlez.
Avez-vous vécu un moment « je suis passé à côté » avec un agent de code ? Qu’est-ce qui manquait à son contexte ? Dites-le-moi dans les commentaires ci-dessous.
Meji
Meji idi ilua…